
Transformers documentation
UPerNet
نُشر هذا النموذج في أوراق HF في 26 يوليو 2018، وأُضيف إلى مكتبة Hugging Face Transformers في 16 يناير 2023.
UPerNet
نظرة عامة
قُدِّم نموذج UPerNet في Unified Perceptual Parsing for Scene Understanding بواسطة Tete Xiao وYingcheng Liu وBolei Zhou وYuning Jiang وJian Sun. يُعد UPerNet إطاراً عاماً لتجزئة مجموعة واسعة من المفاهيم من الصور بفعالية، بالاستفادة من أي عمود فقري بصري مثل ConvNeXt أو Swin.
المستخلص من الورقة البحثية هو كالتالي:
يتعرّف البشر على العالم البصري على مستويات متعددة: فنصنّف المشاهد ونكتشف الكائنات بداخلها بسلاسة، مع تحديد فينيتها وأسطحها إلى جانب أجزائها التركيبية المختلفة. في هذه الورقة، ندرس مهمة جديدة تُسمى التحليل الإدراكي الموحّد (Unified Perceptual Parsing)، والتي تتطلب من أنظمة الرؤية الآلية التعرف على أكبر عدد ممكن من المفاهيم البصرية من صورة معيّنة. تم تطوير إطار عمل متعدد المهام يُسمى UPerNet واستراتيجية تدريب للتعلم من تعليقات الصور غير المتجانسة. قمنا باختبار إطار عملنا على التحليل الإدراكي الموحّد وأظهرنا أنه قادر على تجزئة مجموعة واسعة من المفاهيم من الصور بفعالية. تم تطبيق الشبكات المدرَّبة بعد ذلك لاكتشاف المعرفة البصرية في المشاهد الطبيعية.
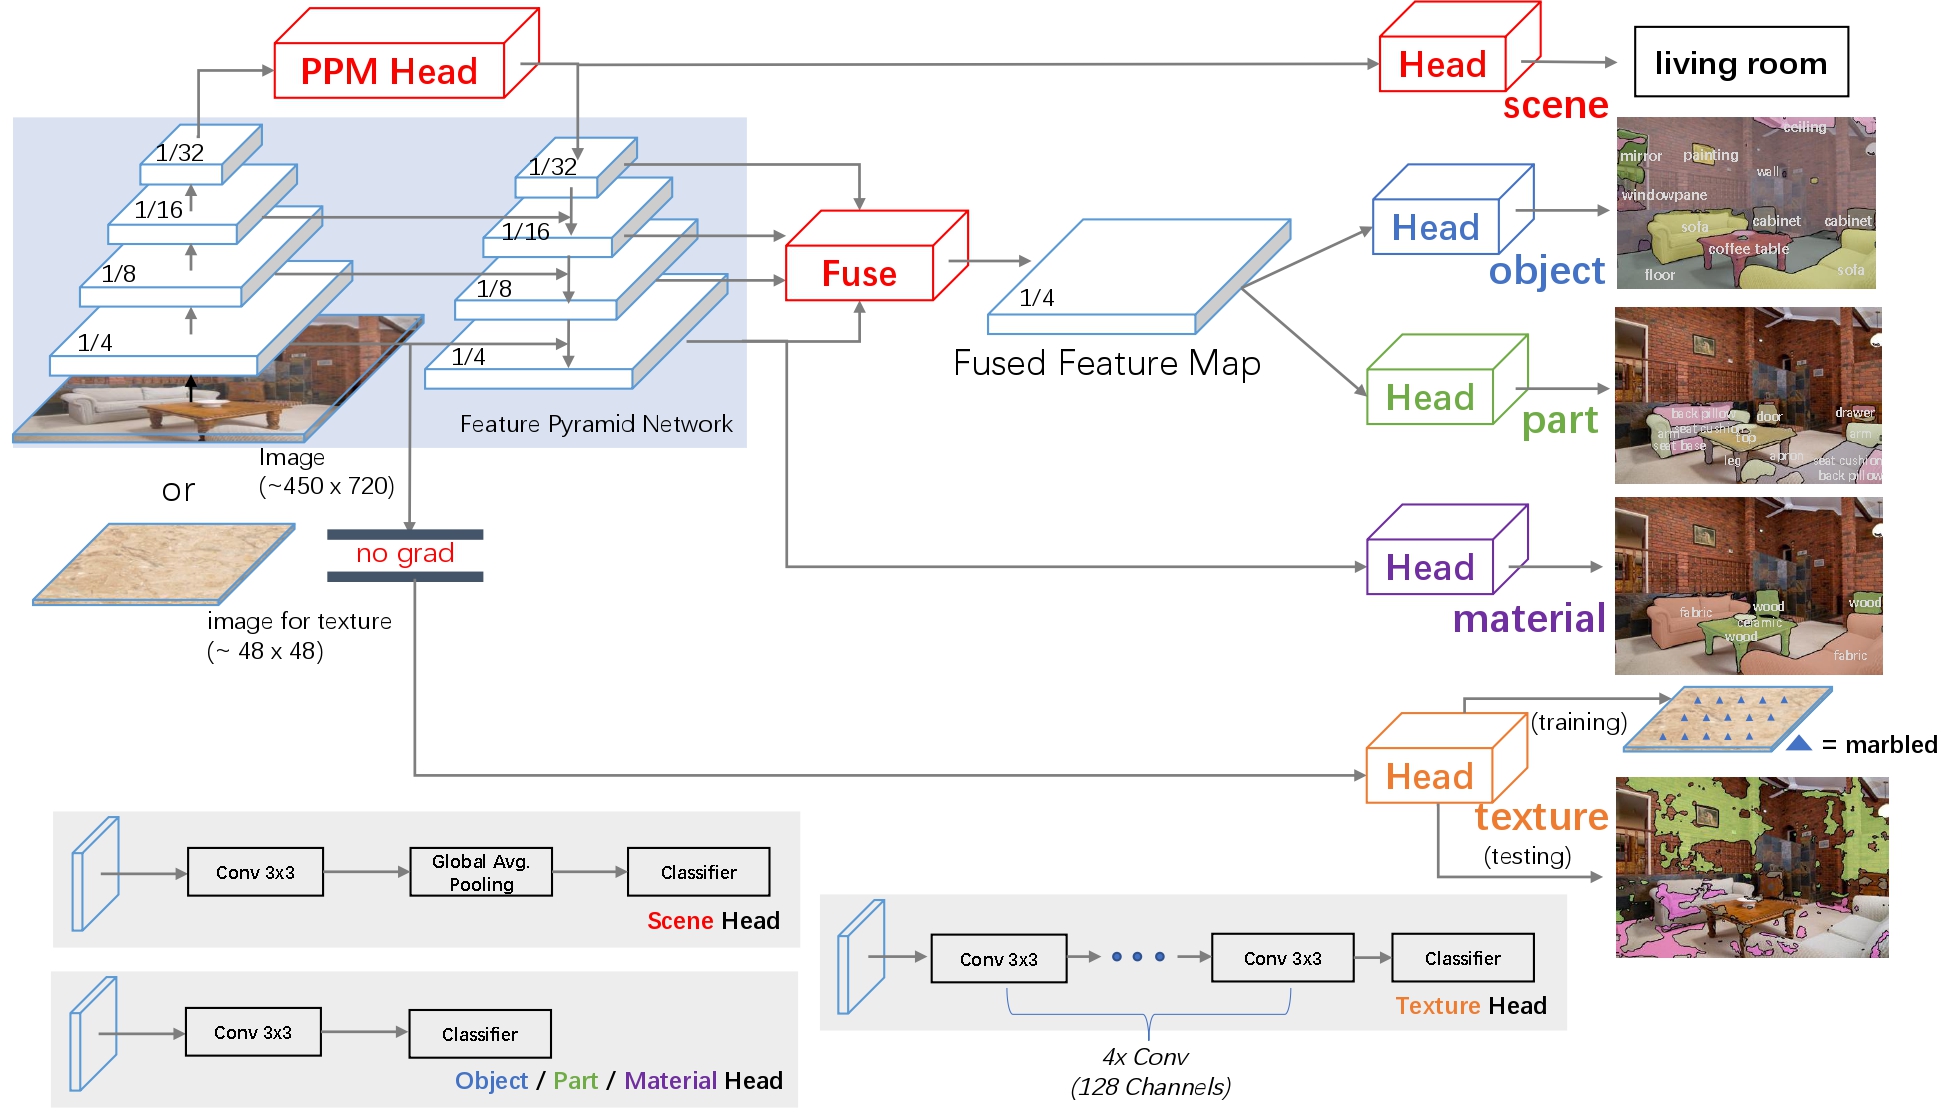 UPerNet framework. Taken from the original paper.
تمت مساهمة هذا النموذج من قِبل nielsr. يعتمد الكود الأصلي على mmsegmentation الخاص بـ OpenMMLab هنا.
أمثلة على الاستخدام
UPerNet هو إطار عام للتجزئة الدلالية. يمكن استخدامه مع أي عمود فقري للرؤية، على النحو التالي:
from transformers import SwinConfig, UperNetConfig, UperNetForSemanticSegmentation


backbone_config = SwinConfig(out_features=["stage1", "stage2", "stage3", "stage4"])

config = UperNetConfig(backbone_config=backbone_config)
model = UperNetForSemanticSegmentation(config)
لاستخدام عمود رؤية آخر، مثل ConvNeXt، ما عليك سوى إنشاء النموذج مع العمود المناسب:
from transformers import ConvNextConfig, UperNetConfig, UperNetForSemanticSegmentation


backbone_config = ConvNextConfig(out_features=["stage1", "stage2", "stage3", "stage4"])

config = UperNetConfig(backbone_config=backbone_config)
model = UperNetForSemanticSegmentation(config)
لاحظ أن هذا سيؤدي إلى تهيئة جميع أوزان النموذج بشكل عشوائي.
الموارد
قائمة بموارد رسمية من Hugging Face وموارد مجتمعية (مشار إليها بـ 🌎) لمساعدتك على البدء باستخدام UPerNet.
- يمكن العثور على كراسات العرض الخاصة بـ UPerNet هنا.
- يُؤمّن هذا دفتر الملاحظات دعمًا لـ UperNetForSemanticSegmentation.
- انظر أيضاً: دليل مهمة التقسيم الدلالي
إذا كنت مهتمًا بتقديم مورد ليُدرج هنا، فلا تتردد في فتح طلب سحب وسنقوم بمراجعته! يُفضَّل أن يُظهر المورد شيئًا جديدًا بدلاً من تكرار مورد موجود مسبقًا.
UperNetConfig
فئة transformers.UperNetConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonehidden_size: int = 512initializer_range: float = 0.02pool_scales: list[int] | tuple[int, ...] = (1, 2, 3, 6)use_auxiliary_head: bool = Trueauxiliary_loss_weight: float = 0.4auxiliary_in_channels: int | None = Noneauxiliary_channels: int = 256auxiliary_num_convs: int = 1auxiliary_concat_input: bool = Falseloss_ignore_index: int = 255 )
المعاملات
- backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — إعدادات نموذج الهيكل العظمي. - hidden_size (
int، اختياري، القيمة الافتراضية512) — أبعاد التمثيلات المخفية. - initializer_range (
float، اختياري، القيمة الافتراضية0.02) — الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - pool_scales (
tuple[int]، اختياري، القيمة الافتراضية[1, 2, 3, 6]) — مقاييس التجميع المستخدمة في وحدة هرم التجميع المطبقة على خريطة الميزات الأخيرة. - use_auxiliary_head (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان سيتم استخدام رأس مساعد أثناء التدريب. - auxiliary_loss_weight (
float، اختياري، القيمة الافتراضية 0.4) — وزن دالة الخسارة المتقاطعة (cross-entropy loss) للرأس المساعد. - auxiliary_in_channels (
int، اختياري، القيمة الافتراضية 256) — عدد قنوات الإدخال في الرأس المساعد. - auxiliary_channels (
int، اختياري، القيمة الافتراضية 256) — عدد القنوات المستخدمة في الرأس المساعد. - auxiliary_num_convs (
int، اختياري، القيمة الافتراضية 1) — عدد طبقات الالتفاف المستخدمة في الرأس المساعد. - auxiliary_concat_input (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب دمج مخرج الرأس المساعد مع المدخل قبل طبقة التصنيف. - loss_ignore_index (
int، اختياري، القيمة الافتراضية 255) — المؤشر الذي تتجاهله دالة الخسارة.
هذه فئة الإعدادات المخزنة لإعدادات نموذج UpernetModel. تُستخدم لاستحداث نموذج Upernet وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ openmmlab/upernet-convnext-tiny
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
أمثلة:
>>> from transformers import UperNetConfig, UperNetForSemanticSegmentation

>>> # Initializing a configuration
>>> configuration = UperNetConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = UperNetForSemanticSegmentation(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
UperNetForSemanticSegmentation
فئة transformers.UperNetForSemanticSegmentation
< source >( config: UperNetConfig )
المعاملات
- config (UperNetConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعداد إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
إطار عمل UperNet الذي يستفيد من أي عمود فقري بصري، على سبيل المثال، لـ ADE20k وCityScapes.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonelabels: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = None**kwargs ) → SemanticSegmenterOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)، اختياري) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام SegformerImageProcessor. راجع SegformerImageProcessor.call() للتفاصيل (يستخدمprocessor_classSegformerImageProcessor لمعالجة الصور). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - labels (
torch.LongTensorمن الشكل(batch_size, height, width)، اختياري) — خرائط التقسيم الدلالي الصحيحة (Ground truth) لحساب الخسارة. يجب أن تكون الفهارس ضمن[0, ..., config.num_labels - 1]. إذا كانconfig.num_labels > 1، يتم حساب خسارة التصنيف (Cross-Entropy). - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
SemanticSegmenterOutput أو tuple(torch.Tensor)
SemanticSegmenterOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة اعتماداً على الإعداد (UperNetConfig) والمدخلات.
تتجاوز طريقة UperNetForSemanticSegmentation الخاصة بالتقديم (forward) الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorمن الشكل(1,)، اختياري، يُعاد عند توفيرlabels) — خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).logits (
torch.Tensorمن الشكل(batch_size, config.num_labels, logits_height, logits_width)) — درجات التصنيف لكل بكسل.The logits returned do not necessarily have the same size as the
pixel_valuespassed as inputs. This is to avoid doing two interpolations and lose some quality when a user needs to resize the logits to the original image size as post-processing. You should always check your logits shape and resize as needed.hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, patch_size, hidden_size).حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, patch_size, sequence_length).أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from transformers import AutoImageProcessor, UperNetForSemanticSegmentation
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download

>>> image_processor = AutoImageProcessor.from_pretrained("openmmlab/upernet-convnext-tiny")
>>> model = UperNetForSemanticSegmentation.from_pretrained("openmmlab/upernet-convnext-tiny")

>>> filepath = hf_hub_download(
...     repo_id="hf-internal-testing/fixtures_ade20k", filename="ADE_val_00000001.jpg", repo_type="dataset"
... )
>>> image = Image.open(filepath).convert("RGB")

>>> inputs = image_processor(images=image, return_tensors="pt")

>>> outputs = model(**inputs)

>>> logits = outputs.logits  # shape (batch_size, num_labels, height, width)
>>> list(logits.shape)
[1, 150, 512, 512]