
Transformers documentation
Table Transformer
نُشر هذا النموذج في أوراق HF في 30 سبتمبر 2021، وأُضيف إلى مكتبة Hugging Face Transformers في 18 أكتوبر 2022.
Table Transformer
نظرة عامة
قُدِّم نموذج Table Transformer في PubTables-1M: Towards comprehensive table extraction from unstructured documents من قِبل Brandon Smock وRohith Pesala وRobin Abraham. يقدّم المؤلفون مجموعة بيانات جديدة باسم PubTables-1M لقياس التقدم في استخراج الجداول من المستندات غير المهيكلة، إضافةً إلى التعرف على بنية الجداول والتحليل الوظيفي. يدرب المؤلفون نموذجين من DETR، أحدهما لكشف الجداول والآخر للتعرف على بنية الجداول، ويُطلق عليهما اسم Table Transformers.
المستخلص من الورقة البحثية هو كالتالي:
أُحرِزَ مؤخراً تقدمٌ كبيرٌ في تطبيق تعلّم الآلة على مشكلة استنتاج بنية الجداول واستخراجها من المستندات غير المهيكلة. ومع ذلك، لا يزال أحد أكبر التحديات يتمثل في إنشاء مجموعات بيانات ذات حقيقة أساسية كاملة وغير غامضة على نطاق واسع. لمعالجة ذلك، طوّرنا مجموعة بيانات جديدة وشاملة أكثر لاستخراج الجداول، تُدعى PubTables-1M. تحتوي PubTables-1M على ما يقرب من مليون جدول من المقالات العلمية، وتدعم عدة أوضاع إدخال، وتحتوي على معلومات تفصيلية حول الترويسات والمواقع لبنية الجداول، مما يجعلها مفيدة لمجموعة واسعة من أساليب النمذجة. كما تعالج مصدراً كبيراً لعدم اتساق الحقيقة الأساسية الذي لوحظ في مجموعات البيانات السابقة ويُسمى الإفراط في التقطيع (oversegmentation)، باستخدام إجراء توحيد جديد. نُظهر أن هذه التحسينات تؤدي إلى زيادة كبيرة في أداء التدريب وتقدير أكثر موثوقية لأداء النموذج عند التقييم في التعرف على بنية الجداول. علاوة على ذلك، نُظهر أن نماذج كشف الكائنات القائمة على المحولات (transformers) والمدربة على PubTables-1M تُنتج نتائج ممتازة لجميع المهام الثلاث: الكشف، والتعرف على البنية، والتحليل الوظيفي، دون الحاجة إلى أي تخصيص خاص لهذه المهام.
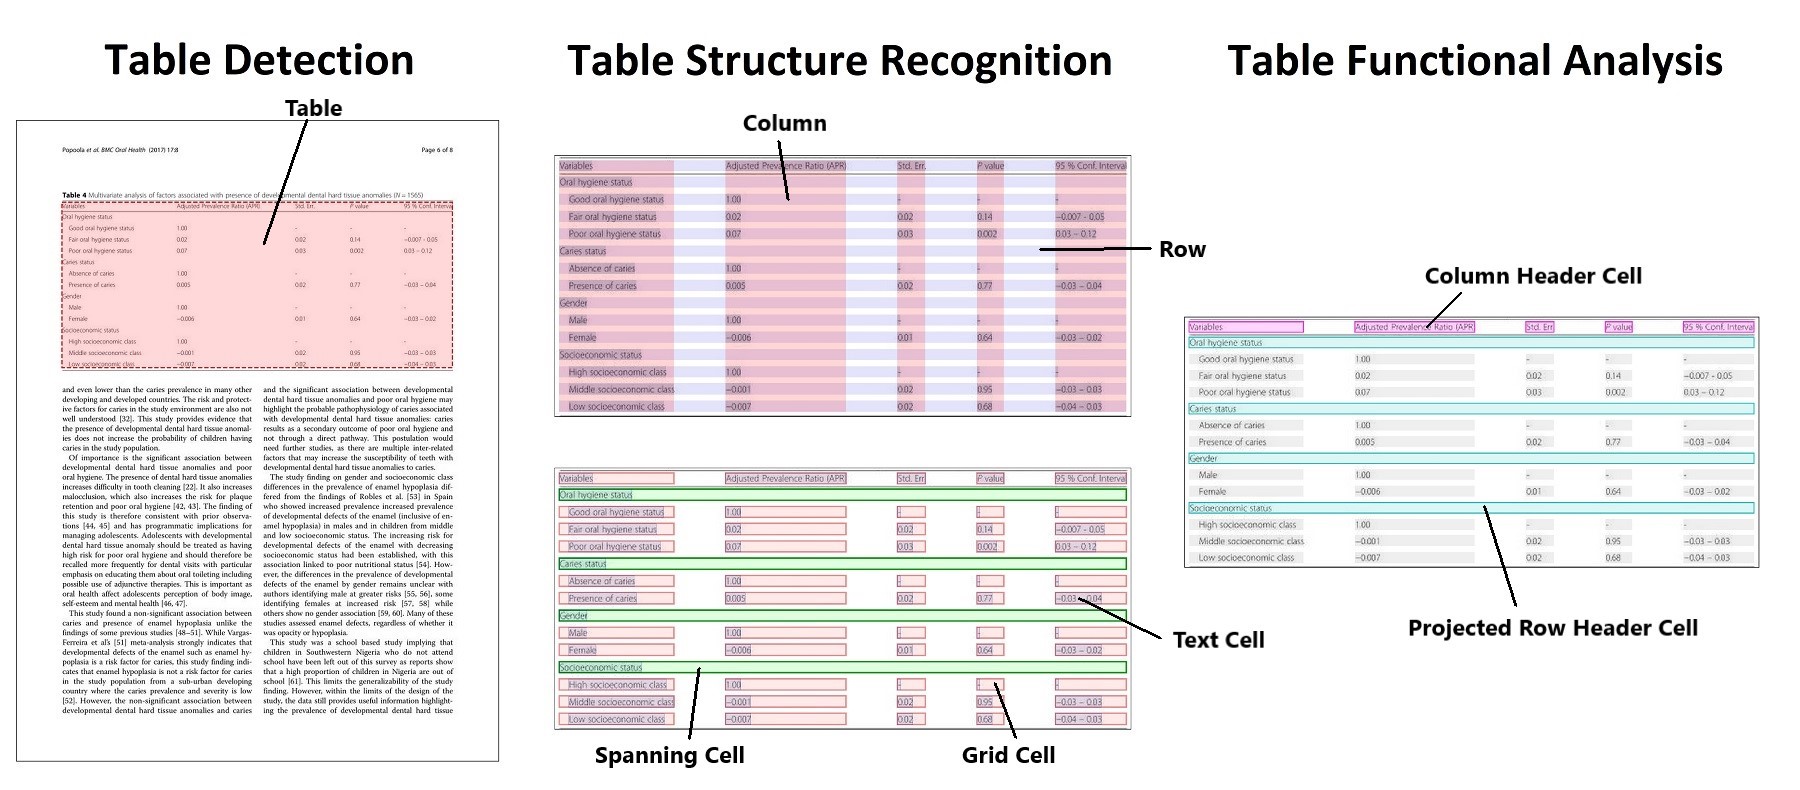 Table detection and table structure recognition clarified. Taken from the original paper.
أصدر المؤلفان نموذجين، أحدهما لـكشف الجداول في المستندات، والآخر لـالتعرف على بنية الجدول (المهمة المتعلقة بالتعرف على الصفوف والأعمدة الفردية وما إلى ذلك داخل الجدول).
تمت مساهمة هذا النموذج من قِبل nielsr. يمكن العثور على الكود الأصلي هنا.
اضبط
use_kernels=Trueفي from_pretrained() لاستبدال الطبقات المدعومة بنوى مُحسَّنة من Hub. راجع تحميل النوى لمعرفة المزيد.
الموارد
- يمكن العثور على دفتر ملاحظات تجريبي لـ Table Transformer هنا.
- تبيّن أن حشو الصور مهم جداً للكشف. يمكن العثور على خيط مثير للاهتمام على Github يتضمن ردوداً من المؤلفين هنا.
TableTransformerConfig
فئة transformers.TableTransformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truebackbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonenum_channels: int = 3num_queries: int = 100encoder_layers: int = 6encoder_ffn_dim: int = 2048encoder_attention_heads: int = 8decoder_layers: int = 6decoder_ffn_dim: int = 2048decoder_attention_heads: int = 8encoder_layerdrop: float | int = 0.0decoder_layerdrop: float | int = 0.0activation_function: str = 'relu'd_model: int = 256dropout: float | int = 0.1attention_dropout: float | int = 0.0activation_dropout: float | int = 0.0init_std: float = 0.02init_xavier_std: float = 1.0auxiliary_loss: bool = Falseposition_embedding_type: str = 'sine'dilation: bool = Falseclass_cost: int = 1bbox_cost: int = 5giou_cost: int = 2mask_loss_coefficient: int = 1dice_loss_coefficient: int = 1bbox_loss_coefficient: int = 5giou_loss_coefficient: int = 2eos_coefficient: float = 0.1 )
المعاملات
- is_encoder_decoder (
bool، اختياري، القيمة الافتراضيةTrue) — ما إذا كان النموذج يُستخدم كمُشفِّر/مُفكِّك أم لا. - backbone_config (
Union[dict, ~configuration_utils.PreTrainedConfig], اختياري) — إعدادات نموذج الهيكل العظمي. - num_channels (
int، اختياري، القيمة الافتراضية3) — عدد قنوات الإدخال. - num_queries (
int، اختياري، القيمة الافتراضية 100) — عدد استعلامات الكائنات، أي فتحات الكشف. هذا هو الحد الأقصى لعدد الكائنات التي يمكن لنموذج TableTransformerModel اكتشافها في صورة واحدة. بالنسبة إلى COCO، نوصي باستخدام 100 استعلام. - encoder_layers (
int, اختياري، القيمة الافتراضية6) — عدد الطبقات المخفية في مُشفِّر Transformer. سيستخدم القيمة نفسها لـnum_layersإذا لم يتم ضبطه. - encoder_ffn_dim (
int، اختياري، القيمة الافتراضية2048) — أبعاد طبقة "الوسط" (التي تُسمّى غالبًا بطبقة التغذية الأمامية) في المُشفِّر. - encoder_attention_heads (
int، اختياري، القيمة الافتراضية8) — عدد رؤوس الانتباه لكل طبقة انتباه في مُشفِّر Transformer. - decoder_layers (
int, اختياري، القيمة الافتراضية6) — عدد الطبقات المخفية في مُفكِّك Transformer. سيُستخدم نفس قيمةnum_layersإذا لم يتم تعيينه. - decoder_ffn_dim (
int، اختياري، القيمة الافتراضية2048) — أبعاد طبقة "الوسط" (التي تُسمّى غالباً بطبقة التغذية الأمامية) في المُفكِّك. - decoder_attention_heads (
int، اختياري، القيمة الافتراضية8) — عدد رؤوس الانتباه لكل طبقة انتباه في مُفكِّك Transformer. - encoder_layerdrop (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمال LayerDrop للمُشفِّر. راجع [ورقة LayerDrop](انظر https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل. - decoder_layerdrop (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — احتمال LayerDrop الخاص بفك الترميز. راجع [ورقة LayerDrop](انظر https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل. - activation_function (
str، اختياري، القيمة الافتراضيةrelu) — دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال،"gelu"،"relu"،"silu"، وغيرها. - d_model (
int، اختياري، القيمة الافتراضية256) — حجم طبقات المُشفِّر وطبقة المُجمِّع. - dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.1) — النسبة لجميع طبقات dropout. - attention_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة إسقاط (dropout) لاحتمالات الانتباه. - activation_dropout (
Union[float, int]، اختياري، القيمة الافتراضية0.0) — نسبة dropout للتفعيلات داخل الطبقة المتصلة بالكامل. - init_std (
float، اختياري، القيمة الافتراضية0.02) — انحراف معياري لمُهيّئ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان. - init_xavier_std (
float، اختياري، القيمة الافتراضية1.0) — عامل التدرّج المستخدم في تهيئة Xavier لأوزان الانتباه المتقاطع. - auxiliary_loss (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان سيتم استخدام خسائر فك الترميز المساعدة (الخسارة في كل طبقة من طبقات فك الترميز). - position_embedding_type (
str، اختياري، القيمة الافتراضية"sine") — نوع تضمينات الموضع المستخدمة فوق ميزات الصورة. إما"sine"أو"learned". - dilation (
bool، اختياري، القيمة الافتراضيةFalse) — ما إذا كان يجب استبدال الخطوة (stride) بالتوسيع (dilation) في كتلة الالتفاف الأخيرة (DC5). يُدعم هذا الخيار فقط عندما يكونuse_timm_backbone=True. - class_cost (
int، اختياري، القيمة الافتراضية1) — الوزن النسبي لخطأ التصنيف في تكلفة المطابقة الهنغارية. - bbox_cost (
int، اختياري، القيمة الافتراضية5) — الوزن النسبي لخطأ صندوق الحدود L1 في تكلفة المطابقة الهنغارية. - giou_cost (
int، اختياري، القيمة الافتراضية2) — الوزن النسبي لخسارة IoU المعممة في تكلفة المطابقة الهنغارية. - mask_loss_coefficient (
int, اختياري، القيمة الافتراضية1) — الوزن النسبي لخسارة التركيز (focal loss) في خسارة التقطيع البانورامي (panoptic segmentation). - dice_loss_coefficient (
int, اختياري، القيمة الافتراضية1) — الوزن النسبي لخسارة دايس (dice loss) في خسارة التقطيع البانورامي (panoptic segmentation). - bbox_loss_coefficient (
int، اختياري، القيمة الافتراضية5) — الوزن النسبي لخسارة صندوق الحدود L1 في خسارة التقطيع البانورامي. - giou_loss_coefficient (
int, اختياري، القيمة الافتراضية2) — الوزن النسبي لخسارة IoU المعممة في خسارة التقطيع البانورامي. - eos_coefficient (
float، اختياري، القيمة الافتراضية0.1) — الوزن النسبي للتصنيف لفئة «لا يوجد كائن» في دالة خسارة كشف الكائنات.
هذه فئة الإعدادات المخزنة لإعدادات نموذج Table Transformer. تُستخدم لاستحداث نموذج Table Transformer وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ microsoft/table-transformer-detection
ترث كائنات التهيئة من PreTrainedConfig ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ PreTrainedConfig لمزيد من المعلومات.
أمثلة:
>>> from transformers import TableTransformerModel, TableTransformerConfig

>>> # Initializing a Table Transformer microsoft/table-transformer-detection style configuration
>>> configuration = TableTransformerConfig()

>>> # Initializing a model from the microsoft/table-transformer-detection style configuration
>>> model = TableTransformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
TableTransformerModel
فئة transformers.TableTransformerModel
< source >( config: TableTransformerConfig )
المعاملات
- config (TableTransformerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Table Transformer الصافي (المكوّن من هيكل أساسي ومحوّل مُشفِّر-مُفكِّك) الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorpixel_mask: typing.Optional[torch.Tensor] = Nonedecoder_attention_mask: typing.Optional[torch.Tensor] = Noneencoder_outputs: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → TableTransformerModelOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسل باستخدام DetrImageProcessor. راجع DetrImageProcessor.call() للتفاصيل (يستخدمprocessor_classDetrImageProcessor لمعالجة الصور). - pixel_mask (
torch.Tensorبشكل(batch_size, height, width), اختياري) — قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة من[0, 1]:- 1 للبيكسلات الحقيقية (أي غير المقنّعة)،
- 0 للبيكسلات التي تمثل حشواً (أي مقنّعة).
- decoder_attention_mask (
torch.Tensorمن الشكل(batch_size, num_queries)، اختياري) — غير مستخدم افتراضيًا. يمكن استخدامه لإخفاء استعلامات الكائنات. - encoder_outputs (
torch.Tensor، اختياري) — مجموعة مرتبة تتكون من (last_hidden_state، اختياري:hidden_states، اختياري:attentions)last_hidden_stateمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) هو تسلسل من حالات المخفية عند مخرج الطبقة الأخيرة من المشفر. يُستخدم في الانتباه المتقاطع (cross-attention) في المُفكِّك. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمرير خريطة الميزات المسطحة (مخرجات الهيكل الأساسي + طبقة الإسقاط)، يمكنك اختيار تمرير تمثيل مسطح للصورة مباشرةً. - decoder_inputs_embeds (
torch.Tensorمن الشكل(batch_size, num_queries, hidden_size)، اختياري) — اختياريًا، بدلًا من تهيئة الاستعلامات بمصفوفة من الأصفار، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
TableTransformerModelOutput أو tuple(torch.Tensor)
TableTransformerModelOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (TableTransformerConfig) والمدخلات.
تُعيد طريقة TableTransformerModel الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)) — تسلسل من حالات الإخفاء عند مخرج الطبقة الأخيرة من فاحم النموذج.إذا تم استخدام
past_key_values، فإن الحالة المخفية الأخيرة فقط من التسلسلات ذات الشكل(batch_size, 1, hidden_size)هي التي تُخرج.past_key_values (
EncoderDecoderCache، اختياري، يُعاد عند تمريرuse_cache=Trueأو عند تعيينconfig.use_cache=True) — إنه كائن من نوع EncoderDecoderCache. لمزيد من التفاصيل، راجع دليل ذاكرة kv.تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي وكتل الانتباه المتقاطع) يمكن استخدامها (انظر مدخل
past_key_values) لتسريع فك الترميز التسلسلي.decoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية (Hidden-states) للوحدة الترميزية (decoder) عند مخرج كل طبقة، بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
decoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من مُشفِّر النموذج.encoder_hidden_states (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) من الشكل(batch_size, sequence_length, hidden_size).حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
encoder_attentions (
tuple(torch.Tensor)، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُشفِّر، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
intermediate_hidden_states (من نوع
torch.Tensorبأبعاد(config.decoder_layers, batch_size, sequence_length, hidden_size)، اختياري، يُعاد عندconfig.auxiliary_loss=True) — تنشيطات المُفكِّك الوسيطة، أي مخرجات كل طبقة من طبقات المُفكِّك، حيث خضع كلٌّ منها لعملية layernorm.
أمثلة:
>>> from transformers import AutoImageProcessor, TableTransformerModel
>>> from huggingface_hub import hf_hub_download
>>> from PIL import Image

>>> file_path = hf_hub_download(repo_id="nielsr/example-pdf", repo_type="dataset", filename="example_pdf.png")
>>> image = Image.open(file_path).convert("RGB")

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/table-transformer-detection")
>>> model = TableTransformerModel.from_pretrained("microsoft/table-transformer-detection")

>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")

>>> # forward pass
>>> outputs = model(**inputs)

>>> # the last hidden states are the final query embeddings of the Transformer decoder
>>> # these are of shape (batch_size, num_queries, hidden_size)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 15, 256]
TableTransformerForObjectDetection
فئة transformers.TableTransformerForObjectDetection
< source >( config: TableTransformerConfig )
المعاملات
- config (TableTransformerConfig) — فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. لا يؤدي التهيئة باستخدام ملف الإعدادات إلى تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة from_pretrained() لتحميل أوزان النموذج.
نموذج Table Transformer (المكوّن من هيكل أساسي ومحوّل مُشفِّر-مُفكِّك) مع رؤوس كشف كائنات في الأعلى، لمهام مثل كشف COCO.
يرث هذا النموذج من PreTrainedModel. راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التحميل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضًا فئة فرعية من torch.nn.Module في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
forward
< source >( pixel_values: Tensorpixel_mask: typing.Optional[torch.Tensor] = Nonedecoder_attention_mask: typing.Optional[torch.Tensor] = Noneencoder_outputs: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonedecoder_inputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: list[dict] | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → TableTransformerObjectDetectionOutput or tuple(torch.Tensor)
المعاملات
- pixel_values (
torch.Tensorمن الشكل(batch_size, num_channels, image_size, image_size)) — المصفوفات المقابلة للصور المدخلة. يمكن الحصول على قيم البكسلات باستخدام DetrImageProcessor. راجع DetrImageProcessor.call() للتفاصيل (يستخدمprocessor_classDetrImageProcessor لمعالجة الصور). - pixel_mask (
torch.Tensorبشكل(batch_size, height, width), اختياري) — قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة من[0, 1]:- 1 للبيكسلات الحقيقية (أي غير المقنّعة)،
- 0 للبيكسلات التي تمثل حشواً (أي مقنّعة).
- decoder_attention_mask (
torch.Tensorمن الشكل(batch_size, num_queries)، اختياري) — غير مستخدم افتراضيًا. يمكن استخدامه لإخفاء استعلامات الكائنات. - encoder_outputs (
torch.Tensor، اختياري) — مجموعة مرتبة تتكون من (last_hidden_state، اختياري:hidden_states، اختياري:attentions)last_hidden_stateمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) هو تسلسل من حالات المخفية عند مخرج الطبقة الأخيرة من المشفر. يُستخدم في الانتباه المتقاطع (cross-attention) في المُفكِّك. - inputs_embeds (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — اختياريًا، بدلاً من تمرير خريطة الميزات المسطحة (مخرجات الهيكل الأساسي + طبقة الإسقاط)، يمكنك اختيار تمرير تمثيل مسطح للصورة مباشرةً. - decoder_inputs_embeds (
torch.Tensorمن الشكل(batch_size, num_queries, hidden_size)، اختياري) — اختياريًا، بدلًا من تهيئة الاستعلامات بمصفوفة من الأصفار، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. - labels (
list[Dict]بطول(batch_size,)، اختياري) — التسميات لحساب خسارة المطابقة الثنائية. قائمة من القواميس، يحتوي كل قاموس على الأقل على المفتاحين التاليين: ‘class_labels’ و ‘boxes’ (تسميات الفئات وصناديق الحدود لصورة في الدفعة على التوالي). يجب أن تكون تسميات الفئات نفسهاtorch.LongTensorبطول(number of bounding boxes in the image,)وأن تكون الصناديقtorch.Tensorبشكل(number of bounding boxes in the image, 4). - output_attentions (
bool، اختياري) — ما إذا كان يجب إرجاع تensors الانتباه لجميع طبقات الانتباه أم لا. راجعattentionsضمن tensors المُرجعة لمزيد من التفاصيل. - output_hidden_states (
bool، اختياري) — ما إذا كان يجب إرجاع حالات الطبقات المخفية لجميع الطبقات. راجعhidden_statesضمن الموترات المُرجعة للحصول على مزيد من التفاصيل. - return_dict (
bool، اختياري) — ما إذا كان يجب إرجاع ModelOutput بدلاً من tuple عادي.
يعيد
TableTransformerObjectDetectionOutput أو tuple(torch.Tensor)
TableTransformerObjectDetectionOutput أو مجموعة مرتبة من
torch.Tensor (في حال تمرير return_dict=False أو عندما يكون config.return_dict=False) وتتضمن عناصر مختلفة
تعتمد على الإعداد (TableTransformerConfig) والمدخلات.
تُعيد طريقة TableTransformerForObjectDetection الخاصة بالتقديم (forward) تعريف الطريقة الخاصة __call__.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن
Moduleبدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
loss (
torch.Tensorof shape(1,), اختياري, يُعاد عند توفيرlabels) — إجمالي الخسارة على شكل تركيبة خطية من سلبية الاحتمال اللوغاريتمي (الإنتروبيا المتقاطعة) للتنبؤ بالفئة وخسارة صندوق الحدود. تُعرَّف الأخيرة على أنها تركيبة خطية من خسارة L1 وخسارة IoU العامة غير المعتمدة على المقياس.loss_dict (
Dict, اختياري) — قاموس يحتوي على الخسائر الفردية. مفيد للتسجيل.logits (
torch.Tensorمن الشكل(batch_size, num_queries, num_classes + 1)) — قيم التصنيف (تشمل فئة لا يوجد كائن) لجميع الاستعلامات.pred_boxes (
torch.Tensorمن الشكل(batch_size, num_queries, 4)) — إحداثيات صناديق مُعايرة لجميع الاستعلامات، ممثّلة على شكل (center_x, center_y, width, height). هذه القيم مُعايرة ضمن [0, 1]، نسبةً إلى حجم كل صورة فردية في الدفعة (مع تجاهل أي حشو محتمل). يمكنك استخدام~TableTransformerImageProcessor.post_process_object_detectionلاسترجاع صناديق الحدود غير المُعايرة.auxiliary_outputs (
list[Dict]، اختياري) — اختياري، يُعاد فقط عند تفعيل الخسائر المساعدة (أي عند ضبطconfig.auxiliary_lossعلىTrue) وتوفير التسميات. وهو قائمة من القواميس تحتوي على المفتاحين المذكورين أعلاه (logitsوpred_boxes) لكل طبقة من طبقات المُفكِّك.last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من فاحص النموذج.decoder_hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية (Hidden states) لمفكّك الترميز (decoder) عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي (initial embedding).
decoder_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
cross_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه لطبقة الانتباه المتقاطع في المُفكِّك، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه المتقاطع.
encoder_last_hidden_state (
torch.Tensorمن الشكل(batch_size, sequence_length, hidden_size)، اختياري) — تسلسل حالات مخفية عند مخرج الطبقة الأخيرة من مُشفِّر النموذج.encoder_hidden_states (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_hidden_states=Trueأو عند تعيينconfig.output_hidden_states=True) — مجموعة منtorch.Tensor(واحدة لإخراج الطبقات المضمنة، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لإخراج كل طبقة) بأبعاد(batch_size, sequence_length, hidden_size).حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
encoder_attentions (
tuple[torch.Tensor]، اختياري، يُعاد عند تمريرoutput_attentions=Trueأو عند تعيينconfig.output_attentions=True) — مجموعة منtorch.Tensor(واحدة لكل طبقة) بأبعاد(batch_size, num_heads, sequence_length, sequence_length).أوزان الانتباه في المُشفِّر، بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
>>> from huggingface_hub import hf_hub_download
>>> from transformers import AutoImageProcessor, TableTransformerForObjectDetection
>>> import torch
>>> from PIL import Image

>>> file_path = hf_hub_download(repo_id="nielsr/example-pdf", repo_type="dataset", filename="example_pdf.png")
>>> image = Image.open(file_path).convert("RGB")

>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/table-transformer-detection")
>>> model = TableTransformerForObjectDetection.from_pretrained("microsoft/table-transformer-detection")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)

>>> # convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> target_sizes = torch.tensor([image.size[::-1]])
>>> results = image_processor.post_process_object_detection(outputs, threshold=0.9, target_sizes=target_sizes)[
...     0
... ]

>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
...     box = [round(i, 2) for i in box.tolist()]
...     print(
...         f"Detected {model.config.id2label[label.item()]} with confidence "
...         f"{round(score.item(), 3)} at location {box}"
...     )
Detected table with confidence 1.0 at location [202.1, 210.59, 1119.22, 385.09]